07 資料洩漏:偷看答案
導航:← 06 梯度提升 | 目錄 | 08 誤判率與BH →
每題的解答都收合在題目下方:先自己作答,再點開「看解答」核對。
先認識這些詞
這一課新出現的詞如下(前面課程已解釋過的詞不重複,完整列表見 術語表)。
- 資料洩漏:模型在學習時不小心看到了答案,成績會虛高。
- 自我注入:目標平台(AVP)用自己的參照題,人工製造假灌票來訓練模型(第 5 階段)。
目標
讀完這課,你能說出三種常見的洩漏,並知道在程式裡要去哪裡找。
白話
資料洩漏:模型在訓練或設計時,不小心看到了它本來不該知道的資訊,於是考試分數虛高。
例子:老師把考題答案寫在練習題的解答旁邊。學生練習時看到答案,考試分數很高,但這不代表學會了。
研究裡要特別注意的三種洩漏
1. 檢驗題混入訓練 檢驗題的特徵或標籤出現在訓練步驟中。
- 例子:字典用了檢驗題建立。
- 查法:找每一個
.fit(的輸入,確認只來自參照題或來源域。
2. 跨平台身分洩漏 跨域模型用到了來源平台的身分(帳號、錢包)。
- 例子:特徵裡有「這個帳號以前投過哪些題」。
- 查法:列出跨域模型的所有欄位,逐一確認目標平台也有。
3. 超參數用檢驗題調 超參數(例如樹的深度)是看檢驗題的分數挑出來的。
- 例子:試了 10 組參數,挑出檢驗分數最高的那組。
- 查法:確認超參數記錄在協定的預先登記中,且在看到結果之前就定了。
4. 標籤由特徵定義(循環) 如果真實標籤是由某些特徵直接定義的,模型只要學會那些特徵,就能「猜中」標籤,成績會虛高。
- 例子:Decentraland 的真實標籤是 Hop 女巫名單中帳號投的票。如果模型用了帳號歷史,它就可能直接學到「哪些帳號是女巫」。
- 查法:問自己,標籤的定義是否用到了輸入特徵?
- 研究中的數字:Decentraland 只用帳號歷史的 AUC 是 0.896,與含帳號歷史的 R2(0.893)相當,甚至略高。但 YelpNYC 只用帳號歷史只有 0.679,明顯較低,因為 Yelp 的過濾標籤不是由帳號歷史直接定義的。
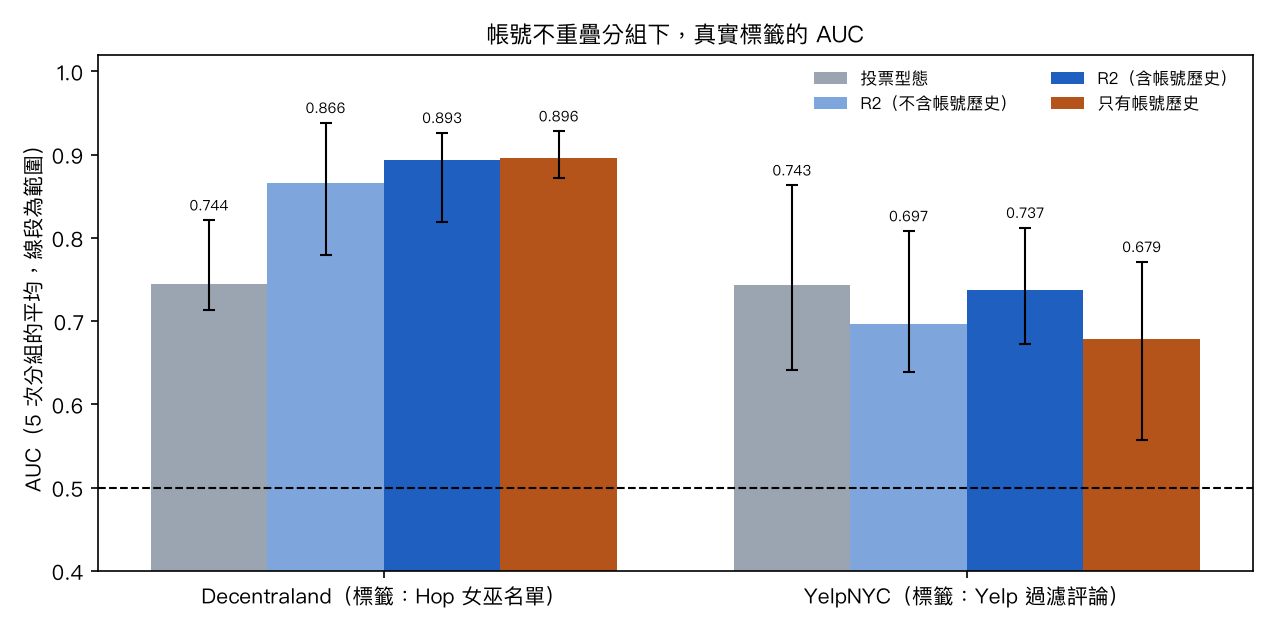
圖 7-1 帳號不重疊分組(五次分組,平均與範圍)下,真實標籤的 AUC。Decentraland 的標籤來自 Hop 女巫名單,只用帳號歷史的 AUC 為 0.896;YelpNYC 的標籤來自 Yelp 過濾評論,同樣的特徵只有 0.679。數據來自
outputs/phase02g/disjoint_summary.csv,由figures/make_figures.py生成。
研究的防線
- 切分:參照與檢驗分開(第 4 課)。
- 注入:參照題注入只選參照題,檢驗題注入只選檢驗題(
src/attacks.py第 91–92 行)。 - 預先登記:超參數與判定規則在執行前寫進協定,並以版本控制保存。
- 帳號不重疊分組:真實標籤的實驗中,把帳號分成 A、B 兩組,訓練與檢驗各用一組,避免同一批帳號同時出現在兩邊(
outputs/phase02g/,第 2h 階段)。
看這裡
src/attacks.py第 91–92 行:set_mask,注入的題目範圍。src/reallabel2.py:帳號不重疊分組與反向檢查(第 2h 階段)。src/selfinj.py第 38–42 行:自我注入只在參照題進行。doc/runbook/v13/review/spec_check/d_minus_e_check.py:這支腳本已經驗證過 d−e 的數字,可以看它怎麼比對。
問自己
1. 我在程式裡找到的每一個 .fit(,它的輸入來自哪裡?
看解答
逐一找出每個 .fit( 的輸入,確認來源只有參照題、來源域,或訓練表。這是查洩漏的基本動作。
2. 如果把檢驗題的標籤打亂(換成隨機),AUC 會變嗎?應該變成多少?如果沒有變,代表什麼?
看解答
AUC 應該降到約 0.5。如果把檢驗題的標籤打亂後,AUC 沒有變,代表評分流程可能根本沒有用到標籤,需要回頭檢查。
3. 字典、特徵、切分三者之間,有沒有任何一步「回頭看」了檢驗題?
看解答
要逐一檢查字典、特徵、切分與模型訓練。本研究的設計是這些步驟只用參照題或來源域的資料。唯一的例外是建圖時用到目標域全部題目的無標籤時間(見 B 課),這不是標籤洩漏。
練習
下面的流程有沒有洩漏?
1. 先用全部題目算平均票數,再切分參照與檢驗。
看解答
有洩漏(但影響可能小)。檢驗題的票數進入了平均值,而這個平均值被用在參照與檢驗兩邊。
2. 先切分,再只用參照題算平均票數。
看解答
沒有洩漏。切分後,檢驗題完全不參與計算。
檢核
1. 資料洩漏的白話意思是什麼?
看解答
模型在訓練或設計時看到了不該看到的資訊,於是考試分數虛高,看起來比實際好。
2. 研究中最需要檢查的是哪一步?
看解答
切分後的每一步:字典、特徵、模型訓練,以及跨域時使用的欄位。特別要看每一個訓練步驟的輸入來源。
3. 為什麼超參數的事前登記很重要?
看解答
事前登記能證明參數不是為了檢驗題調出來的。沒有登記,就無法排除「看了結果再調參數」的隱性洩漏。
導航
引用文獻
- Kaufman, S., Rosset, S., Perlich, C., & Stitelman, O. (2012). Leakage in data mining: Formulation, detection, and avoidance. ACM Transactions on Knowledge Discovery from Data, 6(4). [未收入 bib] — 資料洩漏的正式定義與偵測方法。